Excellent : après la découverte d’une grosse boulette sur les distributions Alpine Linux, dont les images Docker permettaient l’accès root sans mot de passe (durant 3 ans !), les chercheurs ont poussé leur recherche dans les 1000 images les plus utilisées1. Au total 194 images (sur 1000) sont dans le même cas (root sans mot de passe).
Bien que n’ayant pas tous les détails, voici un bel exemple d’illustration de ce qu’est la responsabilité partagée, quand on est dans le cloud.
Une base de données non protégée, hébergée chez AWS, a fait fuiter des millions d’informations sur des « influenceurs » d’Instagram2 (qui appartient à Facebook…) y compris des données privées. Or c’est au propriétaire de la base, une société nommée Chtrbox, qu’il appartient de sécuriser sa base de données.
Patch XP et Windows 7
Bien que le support de ces versions de Windows soit théoriquement terminé (au moins pour le grand public), Microsoft a sorti des patchs de sécurité sur ces produits en mai 20193456.
Pourquoi ?
En raison d’une faille de sécurité sur RDP (Remote Desktop Protocol) si grave qu’on redoute un nouveau WannaCry, rien de moins (à savoir un programme malveillant se propageant sous la forme de ver réseau).
La technique de l’authentification basée sur des assertions (ou « claims-based identity ») est un concept extrêmement intéressant sur lequel est basé SAML. Un des principaux attraits de cette technologie est de permettre la fédération d’identité.
Principes
Très concrètement, un système de jetons de sécurité (STS an anglais, pour Security Token Service) permet la gestion de l’identité d’un utilisateur (et de ses droits). Un des grands intérêts de ce concept est de permettre des relations de confiance entre STS, ce qui permet à différents systèmes d’authentification de propager une identité, et donc de créer des fédérations d’identité.
Les briques
Il y a 3 composants dans un tel système :
Le fournisseur d’identité, qui est un STS ;
Un fédérateur d’identité, qui est aussi un STS ;
Une bibliothèque permettant d’utiliser les jetons, au niveau de l’application cible.
Chez Microsoft
Microsoft permet la mise en œuvre d’un tel mécanisme soit dans son propre système d’information, soit dans le cloud.
Attention : L’Active Directory d’Azure est différent de l’Active Directory classique, car ses fonctionnalités sont limitées à celles utiles pour la gestion d’identité. Il n’y a par exemple rien sur la gestion des politiques des postes Windows rattachés, ce qui est une fonctionnalité très importante dans Active Directory.
Dans le cas où on part d’un fournisseur d’identité interne (ex : Windows Server Active Directory with ADFS) pour se connecter à une application externe via Azure Active Directory, on a besoin d’une synchronisation entre le fournisseur d’identité et le fédérateur. ==> A creuser. A contrario, on peut utiliser Azure AD Access Control en tant que fédérateur d’identité, où la synchronisation est inutile, ce qui est beaucoup plus propre.
XML, comme toute technologie informatique, est potentiellement utilisable de façon détournée par de méchants pirates. Autrement dit, XML est attaquable. Certaines attaques sont relativement communes, d’autres sont plus spécifiques à la technologie elle-même.
Attaques XXE
Une attaque XXE consiste à utiliser le mécanisme XML External Entities qui permet de charger, dans un document XML, des données externes.
Principe
Il suffit donc ensuite que le serveur qui traite le fichier XML ait les droits sur la ressource demandées pour qu’il la récupère. Imaginons que le serveur soit installé sur une instance AWS : on peut très bien mettre, dans l’entité externe à charger, une URL du type //169.254.169.254/latest/meta-data/iam/security-credentials/role/ qui contient les informations d’authentification pour le rôle concerné.
Les données personnelles sont précieuses, au moins encore quelques temps (je ne sais pas si cela va durer). En tout cas, plusieurs lois et règlements imposent à tous ceux qui en traitent de les protéger.
Pour cela, une techniques possible est l’anonymisation des données, qui consiste(rait) à faire en sorte que les données utilisées ne permettent pas de retrouver l’individu qui en est la source (volontaire ou pas).
Critères d’évaluation
En général, on en retient 3 :
L’individualisation, qui consiste à voir si on peut isoler ou pas les données concernant une seule et même personne ;
La corrélation, qui est la faculté de rapprocher des données a priori distinctes d’un seul et même individu (ou d’un groupe d’individus) ;
L’inférence, qui est la possibilité de déduire d’un ensemble de données des caractéristiques d’un individu. Par exemple on arrive à savoir si c’est un homme ou une femme sans avoir aucune indication du sexe dans les données qu’on possède.
Si un seul de ces critères n’est pas respecté, l’anonymisation n’est que partielle. Autant dire qu’une véritable anonymisation est, en pratique, quasiment impossible à obtenir, surtout à l’heure du big data. D’autant que si elle était effective, cela poserait de gros soucis pour réaliser des tests, car l’anonymisation risque de rompre des contraintes d’intégrité ou des contraintes fonctionnelles dans les jeux de données concernés.
Un exemple : Yoodle, un broker de données (beurk), qui annonce suivre les recommandations de son régulateur, fournit à ses clients des données dont le niveau d’anonymisation est très faible (trop faible), car s’il anonymise unitairement les noms, prénoms, numéros de téléphone ou de sécurité sociale, certains libellés de transactions, etc., il suffit souvent de remettre dans un contexte, de croiser les donner avec d’autres infos pour ré-identifier les personnes. Au mieux on peut dire que les données sont pseudonymisées (et non anonymiser).
Il y en a plusieurs types, plus ou moins faciles à mettre en oeuvre, plus ou moins efficace, et plus ou moins utilisables ensuite (dans les tests). Voici une synthèse de ce qui a été publié par l’AFCDP :
Méthodes radicales
La suppression de la donnée : si elle vraiment sensible, on la vire (un point c’est tout) ;
La génération de données (données fictives), la plus efficace mais assez difficile à mettre en oeuvre ;
Le hachage (de préférence avec salage), mais cela pose problème dans leur traitement ; cela ne peut s’appliquer qu’à des données transférées pour lecture et non pour traitement.
Méthodes de lutte contre l’inférence
La variance (vieillissement, modification dans une certaine plage, etc.) ;
Le mélange, où certaines données d’un enregistrement #1 sont mises dans un enregistrement #2, et ainsi de suite ;
La concaténation où on fabrique une donnée à partir d’autres (à préciser…) ;
Dans tous les cas, on risque d’amener un incohérence fonctionnelle dans le jeu de données (par exemple des parents peuvent devenir trop jeunes par rapport à leurs enfants, dans le cas de modification des dates de naissance).
Méthodes partielles
Souvent inadaptées à une anonymisation réelle, elles peuvent néanmoins contribuer à une certaine sécurité, dans certaines conditions.
Le masquage (comme le numéro de la carte de crédit) ou l’appauvrissement pour rendre les données moins précises ;
Le chiffrement qui n’est qu’une anonymisation faible ;
L’obfuscation qui n’a qu’une efficacité faible.
Pseudonymisation
La grande différence entre l’anonymisation et la pseudonymisation est que cette dernière est en principe réversible.
Les grosses données sont des données nombreuses et volumineuses. Concept fumeux et marketing comme toujours, il n’en est pas moins vrai que l’augmentation des performances de stockage et de calcul posent de nouveaux problèmes de sécurité.
Technologie
D’où ça vient ?
Nous produisons de l’information depuis longtemps, bien avant le temps de l’informatique, mais la mémorisation (stockage) des informations (données) était limitée, tout comme leur analyse : il a fallu longtemps se contenter d’un support papier et de son cerveau !
L’authentification multifacteur est une authentification à plusieurs facteurs. Point. Rien d’autre. On confond trop souvent authentification forte et authentification multi-facteurs. L’ANSSI pense comme moi, donc tout va bien.
Examples de dispositifs MFA
Token physiques
Token logiques
Google Authenticator
Quelques failles
Une jolie faille dans ADFS (Active Directory Federation Services), en août 2018 : on oubliait de vérifier l’identité de l’émetteur du second facteur12 …
La biométrie n’est pas, selon moi, adaptée aux processus informatiques. Point final. Et je ne parle même pas des problèmes d’implémentation1… Alors pourquoi ça a le vent en poupe ?
Parce qu’il existe désormais des dispositifs grand public, comme sur les smartphones ;
Parce que c’est confortable ;
Parce que ça donne un faux sentiment de sécurité ;
Parce que le marketing crie plus fort que la sécurité.
Alors pourquoi on nous en vend autant ? Parce qu’on peut en vendre, justement. Avant on ne pouvait pas, car les lecteurs biométriques étaient trop chers. Maintenant qu’ils sont bon marché, on profite de leur prétendue sécurité, issue probablement de l’image véhiculée par le cinéma de science fiction.
FIDO est une alliance créée (en 2012) à l’origine par PayPal et quelques autres acteurs afin d’essayer d’établir un protocole d’authentification sans mot de passe.
Dès 2013, Google, Yubico et NXP1 s’y joignent pour répondre à une problématique forte chez Google de lutte contre le phishing. Pour cela, l’industrie avait besoin d’un standard pour une authentification « forte », et très vite l’idée d’un facteur matériel a été présentée par ces acteurs, avec un protocole ouvert et donc utilisable par tous.
L’acronyme FIDO correspond à Fast IDentity Online, ce qui souligne bien l’orientation web des protocoles. Les grandes étapes historiques de cette alliance sont ici.
FIDO « 1 »
Le besoin initial était de renforcer l’authentification sur des services web ; il était donc naturel d’introduire un second facteur en complément du mot de passe. Fin 2014, les normes FIDO UAF et FIDO U2F sont publiées simultanément.
Premiers protocoles
UAF
UAF correspond à Universal Authentication Framework, qui propose un protocole d’authentification sans mot de passe, à base de cryptographie.
U2F
U2F est la norme concernant le second facteur d’authentification, ou Universal 2nd Factor en anglais, également à base de cryptographie.
A quoi ça sert ?
Grâce à ces normes, on garantit la valeur de l’authentification puisqu’on sait comment cette dernière est établie. Garantir ne signifie pas que l’authentification est parfaite mais qu’on en connaît les mécanismes, et qu’on peut ainsi gérer correctement le risque associé.
Certification
En bonus, une certification peut ainsi être réalisée sur les dispositifs concernés : en utilisant un dispositif FIDO, on sait donc parfaitement comment ce dernier fonctionne. Par la suite, les travaux concernant la certification vont continuer pour suivre l’évolution des technologies et l’accompagner.
La suite
Des travaux viendront compléter ces premières normes, en standardisant les échanges via Bluetooth et NFC, en incluant la biométrie, etc.
FIDO2
En 2016, l’alliance poursuit son travail avec un objectif ambitieux, à savoir créer une norme reconnue pour l’authentification forte sur internet (sur le web).
Pour cela, l’alliance pouvait se baser sur les travaux de la première norme et en 2018 le protocole fut intégré comme candidate recommandation par le W3C, ouvrant la porte à la reconnaissance en tant que standard international de ce qui était en train de devenir FIDO2.
FIDO2 vs. webAuthn
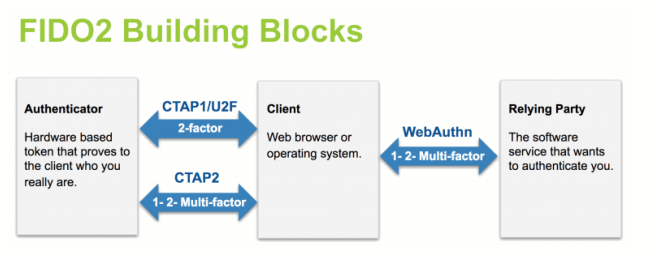
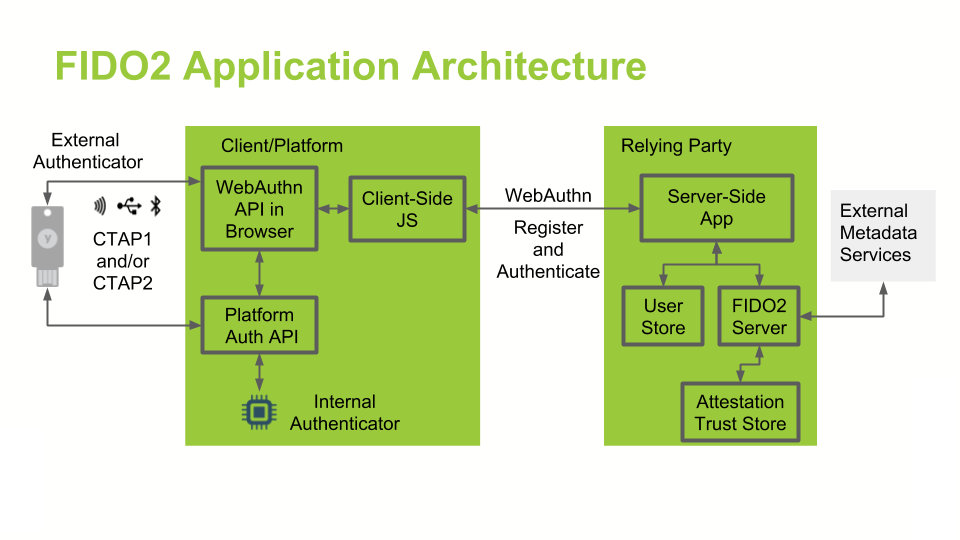
FIDO2 est un ensemble de spécifications, comprenant deux parties :
webAuthn qui est une ensemble de spécifications du W3C, dont le but est d’établir des standards pour le Web ;
CATP qui est un ensemble de spécifications de l’alliance FIDO décrivant un protocole d’authentification entre un client et un dispositif d’authentification communiquant via USB, Bluetooth ou NFC.
FIDO utilise un mécanisme cryptographique pour assurer l’authentification à un site. Chaque authentifiant est unique pour chaque site, le secret ne quittant jamais le dispositif FIDO.
Facilité d’utilisation
Facilité d’utilisation
La facilité d’utilisation provient du dispositif FIDO lui-même, qui gère la partie cryptographique avec le site web. L’authentification sur le dispositif lui-même peut être celui que le client désire (parmi ce qui existe), et est réalisée localement, sans échange avec le serveur web.
Types d’authentification pris en charge
FIDO versions 1 et 2 permettent plusieurs types d’authentification, en combinant les différentes possibilités. En ce ce qui concerne FIDO2 :
Un seul facteur : identité + identifiant (« credential ») FIDO2
Second facteur (complément du 1er) : identité + mot de passe + identifiant FIDO2
Un seul facteur, sans mot de passe : clé cryptographique (« resident key ») FIDO2 stockée sur le dispositif FIDO2
Deux facteurs (MFA) « sans mot de passe » : clé cryptographique FIDO2 + code PIN
Les dispositifs FIDO2 sont également rétro-compatibles avec l’authentification FIDO U2F :
Un seul facteur :identité + identifiant FIDO U2F
Second facteur: identité + mot de passe + identifiant FIDO2 U2F
Points clés
Les identifiants FIDO2 sont basés sur une paire de clé cryptographique de type asymétrique.
Le fournisseur d’identité (« identity provider », ou IdP) valide l’identité de l’utilisateur et associe une clé publique FIDO2 à un compte utilisateur (phase d’enregistrement, souvent appelée improprement enrolement en français).
L’identifiant (« credential ») FIDO2 peut être généré sur un support matériel (clé physique, smartphone, PC portable…) ou par logiciel, selon la politique choisie.
L’authentification utilise une clé cryptographique liée au dispositif d’authentification et, en option, un autre facteur qui peut être de type « ce que je sais » (code PIN) ou « ce que je suis » (biométrie). Cet identifiant complémentaire (PIN ou biométrie) n’est pas diffusé entre les dispositifs d’authentification et n’est pas partagé avec aucun serveur. Il est stocké uniquement sur le dispositif d’authentification.
La clé privée de l’utilisateur (de la paire de clé asymétrique) ne quitte jamais le dispositif d’authentification. Le serveur d’authentification ne conserve que la clé publique associée au compte de l’utilisateur durant la phase d’enregistrement.
La saisie du code PIN, la présentation de la biométrie, ou l’appui sur le bouton présent sur le dispositif sert à débloquer la clé privée afin de signer cryptographiquement les données envoyées au fournisseur d’identité dans l’assertion. Les données signées contiennent également l’indication d’utilisation ou non d’un code PIN ou de la biométrie. La demande d’authentification se poursuit à partir du moment que le fournisseur d’identité a vérifié l’assertion d’authentification.
Just like files that you save on the device’s internal storage, Android stores your database in private disk space that’s associated application. Your data is secure, because by default this area is not accessible to other applications.
Cependant, si on ne suit pas les bonnes pratiques, notamment lors du stockage de données sur des supports externes à l’OS (genre carte SD), les données deviennent vite accessibles pour des intrus1.
Lenteur des mises-à-jour
Une des choses que je reproche le plus à Android est la fragmentation des versions de l’OS, ce qui se comprend par la difficulté d’intégration de tous les acteurs (fabricants de composants et puces, fabricants de smartphones, opérateurs téléphoniques) qui devaient chacun revoir leur copie à chaque mise à jour d’Android, ce qui fait que beaucoup traînaient les pieds ou ne le faisaient carrément pas. Or un OS viable est un OS à jour !
Treble
Depuis Android 8.0, toutes les parties spécifiques que les acteurs précédents devaient modifier a été séparée (logiquement) de l’OS. L’avantage indéniable de la manœuvre est de laisser le code spécifique à part, sans avoir besoin de le retravailler2. Il « suffit » donc de mettre à jour l’OS, pour un téléphone donné, afin d’avoir les derniers correctifs : le travail est du côté de Google, pas des acteurs intervenant par la suite (fondeurs de puces, constructeurs de téléphone et opérateurs).
Android One
Une autre option pour avoir un système à jour est justement de n’utiliser aucune personnalisation du téléphone, en respectant certains critères documentés par Google3. Au final, on aura un téléphone moins personnalisé (personnellement ça m’importe peu) mais surtout suivant (ou plutôt : pouvant suivre) les mises-à-jour Android sans aucun souci.
Google propose même de labelliser les téléphones respectant les critères Android One ; et je ne vois pas l’intérêt qu’aurait un constructeur à s’embêter à être Android One pour ne pas suivre le train des mises-à-jour de l’OS !
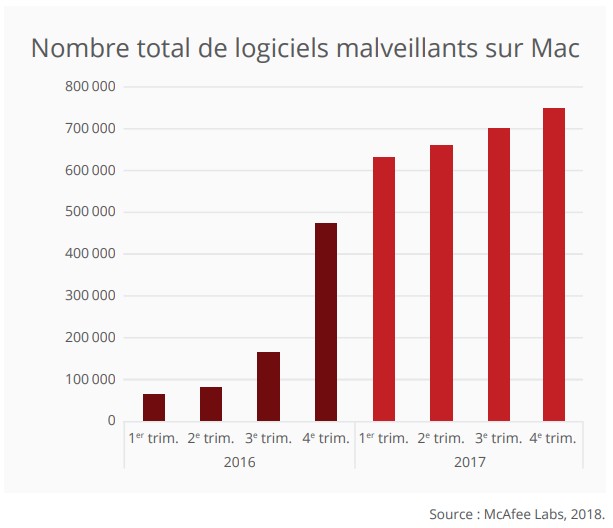
MacOS est-il sécurisé ? Je ne saurais pas mieux répondre que pour Windows ! Un petit mot, en passant, sur les mythes et réalités de l’informatique : j’ai souvent entendu des partisans du Mac (d’Apple) dire que les Mac n’étaient pas sensibles aux virus informatiques. La preuve, selon eux, était qu’on n’entendait jamais parler de virus sur cet environnement. Evidemment, c’est faux. La situation est néanmoins différente sur iOS (sur iPhone).
Logique de marché
Même il y a quelques années, cette affirmation était partiellement fausse : on n’en entendait peu parler, ce qui ne signifie pas qu’on n’en parlait pas du tout. Il y a une logique très simple dans la criminalité, informatique ou pas :
Le crime suit l’usage.
Les cybercriminels suivent donc l’usage : développer un programme malveillant ou toute attaque informatique demande de la préparation, du temps, des moyens, avec l’espérance d’un retour sur investissement pour l’initiateur. Ce retour peut être financier mais pas seulement (les motifs peuvent aller de la recherche de notoriété à l’idéologie).
Quelqu’un voulant attaquer les Mac n’attaquera que des Macintosh. Et donc seulement 10% du marché1 des ordinateurs personnels (à la louche). Donc beaucoup d’efforts pour peu de retours. Autant dire que c’est peu rentable et peu intéressant pour un attaquant.
Donc si les Macs sont moins attaqués, c’est uniquement parce qu’ils sont moins nombreux et moins intéressants.
Sécurité intrinsèque
Par contre, quelqu’un cherchant à attaquer un Mac y arrivera à peu près avec les mêmes techniques qu’un ordinateur PC Windows : il n’y a aucune différence fondamentale entre MacOS et Windows qui, comme tout programme informatique est faillible. Tout l’environnement MacOS peut présenter le même genre de vulnérabilités que des PC sous Windows. Il suffit de regarder les failles régulièrement corrigées par Apple. Les archives des vulnérabilités corrigées remontent au moins à 2003.
A la conférence Black Hat 2018, un chercheur du projet Google Zero a même enjoint Apple de changer de mentalité, car même avec du personnel très compétent en matière de sécurité informatique, la société manque de culture et ignore un peu trop la réalité des exploitations ; il relève même que les exploitations ciblées de vulnérabilités (comme par exemple l’infiltration d’Amnesty grâce à l’outil d’attaque Pegasus) sont beaucoup plus fréquentes2 qu’on ne l’imagine (et qu’Apple ne l’imagine).
Black Hat 2018 : Un éditeur de sécurité montre comme il est facile de contourner le pare-feu d’Apple3.
DefCon 2018 : Un chercheur arrive à avoir accès au noyau (kernel) avec un programme de deux lignes45. Il n’y a pas que Windows à avoir de problèmes de ring 0 ! Plus précisément6, la simulation d’une action souris, trouvée (par hasard ?) par un chercheur (Patrick Wardle, ancien collaborateur de la NSA) voulant vérifier qu’une ancienne vulnérabilité avait été bien corrigée, a permis de découvrir le pot aux roses.
Programmes malveillants
Tordons le cou aux idées reçues : il existe des programmes malveillants7 pour Mac. Leur proportion reste très inférieure à celle de la part de marché des Macs, mais c’est logique par rapport à ce qui est dit plus haut : les retours sur investissement sont faibles, donc les pirates s’y intéressent moins.
Un petit incident concernant le protocole utilisé dans quasiment tous les réseaux wifi actuels, auquel on a donné le nom évocateur de KRACK, est apparu (c’est-à-dire qu’on a communiqué publiquement dessus) aujourd’hui (16 octobre 2017).
En quelques mots : une personne (un équipement) captant physiquement le signal wifi WPA2 d’un réseau, même chiffré en bonne et due forme, peut déchiffrer tout le trafic, et donc lire tout ce qui y passe : la couche de protection WPA2 devient inutile. Si les informations qui transitent sur le réseau ciblé sont en clair, alors on peut les lire sans que vous ne vous en aperceviez. Par contre ce qui est chiffré au niveau supérieur (https, ssh, etc) reste tel quel, avec le niveau de protection attendu.
Bonne question ! L‘attribution d’une attaque est un des problèmes récurrent et quasi-insoluble auquel est confronté la communauté de la sécurité informatique. Il va de soi qu’on souhaite toujours savoir qui nous attaque, mais à l’inverse des attaques militaires (quoique…), il est en pratique très difficile de savoir d’où vient la menace.
De son vrai nom USA Patriot Act (Uniting and Strengthening America by Providing Appropriate Tools Required to Intercept and Obstruct Terrorism Act of 2001). Les américains ont une propension étonnante à l’USA-centrisme. Tout tourne autour d’eux : quand un exterminateur (une météorite dévastatrice) tombe sur la Terre, c’est aux Etats-Unis. Idem pour toutes les catastrophes menaçant l’humanité toute entière.
La technologie de registre distribué a le vent en poupe depuis quelques années (depuis la popularisation des cryptomonnaies telles que le bitcoin). On appelle aussi ça « chaîne de blocs », traduction plus littérale mais technique : ça dit ce que c’est, mais pas ce que ça fait, à l’inverse de « registre distribué ».