Comment avoir un aide-mémoire sur un sujet précis ? Demandez à une (ou plusieurs) IA. Ici j’avais envie de me rafraîchir la mémoire au sujet des JSON token, et voici un mini tutoriel sur github avec des exemples en Python !
Archives de catégorie : Principes généraux
Vision d’ensemble : OAuth → OAuth 2.0 → OIDC
Remettons tout cela en musique et replaçons les choses de façon compréhensible.
Continuer la lectureFact-checking
Où vérifier les informations qui circulent à droite et à gauche ? La tâche est si complexe que même des journalistes s’y perdent et se font avoir. Voici, à titre informatif, quelques sites de vérification d’information. Quoi qu’il en soit, quoi qu’il arrive, multipliez les sources et allez voir les avis contraires pour ne pas vous enfermer dans un schéma (ni dans les statistiques des algorithmes qui vous proposeront toujours la même tendance). Je les ai tous vérifiés au 11/09/2025 mais signalez moi toute erreur ou changement d’URL !
Continuer la lectureDérogation ou acceptation du risque ?
Dans le cadre des normes ISO 27001 et ISO 27005, les notions de dérogation et acceptation du risque sont liées mais distinctes. Il est bon de se rappeler des bases et des définitions exactes et leur application en sécurité des systèmes d’information. Un vocabulaire précis permet souvent un raisonnement précis.
En résumé, l’acceptation du risque est une notion issue de l’analyse de risque et relève donc de la gestion du risque. Elle peut être temporaire ou permanente. La dérogation est issue d’une non conformité (en général à la PSSI) et ne peut être que temporaire.
Continuer la lectureVLAN
Un VLAN (Virtual Local Area Network) est un réseau local virtuel qui permet de regrouper un ensemble d’équipements au sein d’un même réseau local logique, même s’ils sont physiquement dispersés dans un réseau plus large. Un VLAN divise un réseau physique en plusieurs réseaux virtuels distincts, chacun avec ses propres segments, créant ainsi une séparation entre les groupes d’équipements.
Continuer la lectureDue care, due diligence
J’ai toujours eu du mal avec ces deux notions. D’origine juridique, elles s’appliquent également en sécurité informatique. En sécurité informatique, les concepts de « due care » et « due diligence » peuvent être appliqués de la manière suivante :
Continuer la lectureCI/CD
Continuous ceci, continuous cela… A quoi ça rime ? Ou plutôt à quoi ça rythme ? Car l’intégration continue et le déploiement continu sont une question de rythme, oserai-je dire.
Continuer la lectureBonnes pratiques : les bases
Un article fourni (pour une fois) de ZDNet reprend un ensemble de bonnes pratiques, pour un usage personnel. Les outils proposés vont évoluer dans le temps (de nouveaux non cités vont apparaître, d’autres vont disparaître), mais les bases devraient rester stables, et cet article est donc instructif à ce titre.
Continuer la lectureLogique et mathématique
Un ordinateur, c’est bien beau, mais c’est rien qu’une machine. Une machine avec des performances extraordinaires, dans son domaine, mais une machine quoi qu’on en dise : une machine répondant aux lois mathématiques (et donc à la logique mathématique).
Continuer la lectureC’est sûr, l’open source ?
Puisqu’on vous dit que oui car tout le monde peut regarder dans le code que tout va bien et que de toutes façons y a pas de méchant dans les développeurs qui font de l’open source c’est bien connu.
Continuer la lectureZero trust
Ne faites confiance à personne ! Je l’ai souvent entendu dans la vie, et c’est la première chose qu’on apprend quand on fait de la sécurité informatique. Le concept (marketing ou pas) de Zero Trust a vite émergé depuis que la SSI est devenue industrielle, mais c’est quoi ?
Continuer la lectureFake News
Moi qui suit un ardent défenseur de la langue française, je cède ici car l’expression est trop répandue pour ne pas la reprendre. Et surtout le terme fausses informations n’a pas exactement la même signification ni la même connotation complotiste.
Comment ça se passe
Définition
Commençons par tenter de définir ce que c’est. A mon sens, une fake new est une information fausse ou biaisée présentée comme incontestable, dans le but de manipuler les opinions.
Un exemple de manipulation
Création de la source (identité)
Plusieurs techniques sont possibles :
- le piratage pur et simple d’un site d’information ; c’est difficile car il faut s’introduire frauduleusement dans un SI, et risqué juridiquement ;
- la copie visuelle, un peu moins risquée ;
- l’usurpation de noms de domaines (prendre un nom de domaine proche d’un site connu) : on a l’embarras du choix avec les nouveaux TLD ;
- les campagnes de publicité sur des médias reconnus, avec des supports faisant croire à de l’information (genre publi-information, mais avec un but plus clairement malveillant) ;
- le site ad hoc, créé de toute pièces, avec des rédacteurs produisant du contenu régulièrement
Création du faux contenu
Circular reporting
Un mécanisme courant d’apparition et de crédibilisation d’une fausse information est le circular reporting. Le procédé est le suivant :
- Un agent A publie l’information souhaitée, sans source ;
- Un agent B (complice du premier ou trompé par celui-ci) publie l’information (toujours sans source) ;
- L’agent A reprend alors l’information, mais cette fois en citant l’agent B. La boucle est bouclée.
En fonction de la crédibilité ou de la force d’influence de l’agent B, l’information se diffusera plus ou moins rapidement, mais l’agent A pourra désormais donner son information totalement fabriquée avec une source connue (connue ne veut pas dire forcément fiable).
Wikipédia est souvent utilisé comme « agent A », car il est souvent (trop souvent) repris comme source d’information fiable…
Variante : la source cachée
En journalisme, on demande de croiser ses informations en utilisant plusieurs sources différentes.
Or, notamment avec le web, plusieurs médias réputés peuvent reprendre une information dont la source n’est pas connue du lecteur final. Ainsi, ce dernier souhaitant vérifier l’information, ira sur ces différents médias : il aura l’impression d’avoir plusieurs sons de cloche alors qu’en réalité, ces médias ne font que reprendre la même et unique source.
Ca me rappelle un peu ce que je disais à l’époque sur le Web 2.0, avec les flux RSS fleurissant comme des boutons de sébums chez les adolescents, avec pour résultat de vous renvoyer en 50 exemplaires sur 50 sites différents la même information à la virgule près.
Création des faux documents
Tellement facile de nos jours… L’important pour le manipulateur sera d’avoir quelque chose de crédible mais de qualité moyenne, afin d’empêcher toute expertise ou toute recherche de retouche sur une photo, par exemple. Même les vidéos sont facilement contrefaites…
La troncature
Un moyen simple de manipuler un support est de le tronquer pour ne garder qu’une partie en effaçant une partie signifiante du support.
Autre exemple de troncature : cette petite vidéo qui met également en exergue un mécanisme similaire, et très simple à réaliser.
https://embed.koreus.com/00071/201908/lancer-stylo-feutre-pot.mp4
Le doit de réponse oublié
Autre grand travers dans le domaine de fake news : l’absence de visibilité des droits de réponse. En avril 2019, en période de tension entre l’administration américaine et la société Huawei, une nouvelle tombe sur les téléscripteurs : des backdoors auraient été trouvé(e)s sur des équipements réseau Huawei. Or très peu de temps après, Vodafone Italie (pourtant source annoncée de l’information) dément1 en indiquant n’avoir trouvé qu’un accès telnet2. Ok, utiliser ce protocole en soit pourrait être considéré comme une faille, mais il restait pourtant très courant de s’en servir chez les équipementiers réseau.
Faites une recherche Google et vous trouverez cette nouvelle multipliée à l’infini à la date du 30 avril 2019. Ce qui n’apparaît pas clairement est que cette information ne vient que d’une seule source, Bloomberg, qui a pourtant connu des précédents d’informations douteuses34 avec l’affaire SuperMicro5.
Utiliser une information provenant d’une source unique (Bloomberg), ayant eu des problèmes de crédibilité sur le même domaine de la sécurité informatique, pour établir une opinion et des sanctions économiques me semble problématique.
Et ne pas (ou peu ou pas assez) entendre la réponse (crédible ou pas) de Huawei indiquant que ces faits dataient de plusieurs années en arrière (2011 et 2012), que ces problèmes avaient été corrigés et qu’ils n’auraient pas forcément permis un accès à distance par internet2 est tout aussi perturbant.
Diffusion du contenu
Il est impressionnant de voir qu’il n’est pas utile d’écrire beaucoup pour être lu : en positionnant bien son article, avec une accroche bien faite, quelques lignes et une image spectaculaires suffiront.
Un exemple ? Facile !
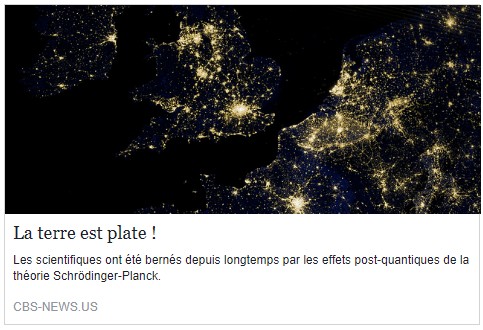
Le canal privilégié sera les réseaux sociaux, très peu modérés ou contrôlés. Mais l’information ne sera reprise que si elle est issue d’un compte ayant une certaine popularité ou s’étant construit une image de confiance (apparente) suffisante.
Le compte créé pour l’occasion
Les comptes créés spécialement pour diffuser des fake news ont souvent des caractéristiques communes :
- Compte récent (car les comptes douteux finissent heureusement souvent par être supprimés) ;
- L’activité est surtout du relais d’information, et peu de création par lui-même ;
- Beaucoup de mentions de type j’aime, ce qui s’achète facilement ;
- En général peu d’abonnés, ou des abonnés de profil douteux (mais c’est difficile à contrôler).
Le compte original (par compromission)
La compromission d’un compte légitime est aussi possible, via phishing ou grâce aux questions secrètes encore beaucoup trop utilisées. Quoi de mieux que l’original pour diffuser une info bidon ?
La contrepartie est la limitation dans le temps : souvent surveillés, ils finissent par être redonnés à leurs propriétaires.
Double switch
Plus subtil, cette technique consiste à compromettre n’importe quel compte ayant un bon niveau de confiance. Sur Twitter, l’attaquant change ensuite le nom du compte pour celui qu’il veut (Donal__Trump par exemple), ce qui libère l’ancien… qu’il peut ensuite reprendre puisqu’il vient lui-même de le libérer !
Ainsi il dispose d’un compte ayant de nombreux followers, avec une identité qu’il a choisie (le compte original), et un autre compte (sans réputation ni followers) mais avec le nom du compte original ! Pas mal avec une seule compromission, non ?
Autres voies (voix)
Tout s’achète, y compris certains comptes de réseaux sociaux (avec leur public de followers). Et les blogs ou autres forums peuvent aussi encore servir, tout comme les commentaires (issus de robots ou pas).
Propagation
Une fois diffusé, le mécanisme continue : il faut toucher le public le plus large possible, et les réseaux sociaux font merveilles dans le domaine (et encore plus s’ils sont aidés par des robots).
Comment on lutte
Comme on peut, surtout que les mesures préconisées sont souvent contradictoires avec la liberté d’expression ou la neutralité du net.
- https://www.theguardian.com/media/2018/apr/24/eu-to-warn-social-media-firms-over-fake-news-and-data-mining
- https://www.reuters.com/article/us-eu-internet-fakenews/eu-piles-pressure-on-social-media-over-fake-news-idUSKBN1HX15D
- http://europa.eu/rapid/press-release_IP-18-3370_fr.htm
Voir aussi
Formations
Voici une page spéciale avec différentes sources de sensibilisation et d’information :
- https://secnumacademie.gouv.fr/
- https://www.skillset.com/ pour évaluer ses connaissances, en vue d’une certification par exemple.
- https://www.skillset.com/
- https://www.information-security.fr/
- https://www.root-me.org/
- https://podcloud.fr/podcast/comptoir-secu (podcasts)
- https://www.reddit.com/r/netsec
- https://www.zenk-security.com/
Outils
Sites, podcasts, etc.
Sensibilisation pour les enfants
- https://www.securitytuesday.com/wp-content/uploads/2018/10/ISSA.Cahier.SecNum777.pdf
- https://github.com/wavestone-cdt/1-2-3-Cyber
RGPD
- https://atelier-rgpd.cnil.fr/ (MOOC de la CNIL)
Biométrie
Voir aussi Le doigt dans l’œil de la biométrie (nextinpact.com).
La biométrie n’est pas, selon moi, adaptée aux processus informatiques. Point final. Et je ne parle même pas des problèmes d’implémentation1… Alors pourquoi ça a le vent en poupe ?
- Parce qu’il existe désormais des dispositifs grand public, comme sur les smartphones ;
- Parce que c’est confortable ;
- Parce que ça donne un faux sentiment de sécurité ;
- Parce que le marketing crie plus fort que la sécurité.
Alors pourquoi on nous en vend autant ? Parce qu’on peut en vendre, justement. Avant on ne pouvait pas, car les lecteurs biométriques étaient trop chers. Maintenant qu’ils sont bon marché, on profite de leur prétendue sécurité, issue probablement de l’image véhiculée par le cinéma de science fiction.
Continuer la lectureDarkweb
La récente salve de francisation de termes informatiques n’a pas fait que des heureux. Plusieurs voix se sont élevées contre l’institutionnalisation de fait de termes abscons, comme darkweb et deepweb dont l’existence même prête à polémique.
Autant un portail de messagerie (« webmail ») est un concept clair pour tous, autant les notions d’internet clandestin (« darkweb ») ou de toile profonde (« deepweb ») n’ont pas de réalité si tangible que ce qu’on veut bien nous faire croire.
Le cas des clandestins
Le Larousse nous apprend que clandestin peut signifier « qui se cache » mais aussi « qui contrevient à la loi ou qui se dérobe au contrôle ». Cela peut tout à fait s’appliquer à l’internet de Mme Michu, car nombre de sites web d’accès public contreviennent allègrement à plusieurs lois françaises : tel site d’un journal people qui reprend des clichés violant la vie privée de personnalités, tel autre qui diffuse de annonces liées à des escroqueries diverses (la bague qui guérit tout, le gain assuré au loto, l’augmentation de volume de [ce qu’on veut], la promesse de gains mirobolifiques sur des marchés financiers qu’on cache être extrêmement risqués), la vente d’armes sur Facebook ou Instagram, etc.
Par ailleurs, se dérober au contrôle est parfois une mesure salutaire notamment dans les pays (grands ou petits) où la censure sévit et où la clandestinité est la seule option permettant de vivre (ou survivre). Aller sur l’onionland ou utiliser des VPN est nécessaire à certains.
Sombre internet
D’après S. Bortzmeyer, la définition correcte de deepweb serait :
Concept débile, peu ou pas défini, flou, et qui ne sert qu’aux politiciens et journalistes sensationnalistes.
La définition officiellement retenue est :
Partie de la toile qui n’est pas accessible aux internautes au moyen des moteurs de recherche usuels.
Ce qui est sans aucun rapport avec la notion qu’on veut mettre dans ce deepweb peuplé uniquement de méchants qui se cachent pour comploter, car il y a un tas de raisons pour lesquelles les moteurs de recherche n’indexent pas : je prenais le cas d’un portail de messagerie, dont la quasi-totalité du contenu n’est accessible qu’à un utilisateur authentifié (et donc inaccessible aux moteurs de recherche). Ce portail de messagerie serait donc à classer dans le deepweb. Or consulter ce deepweb vous expose directement à l’excommunication ou à des poursuites pénales, bien entendu. Idem pour tous les sites utilisant un fichier robots.txt.
Deep ou dark ? Blanc ou noir ?
J’avoue moi-même ne plus bien réussir à faire la différence entre ces deux notions, tant elles sont floues. Une distinction plus simple et plus claire serait peut-être de parler d’activités légales ou d’activités illégales sur internet, quels que soient les moyens employés, puisqu’on peut vendre de la drogue sur l’internet « classique » et tenter de sauver sa famille sur l’internet « clandestin ». Toutefois, le darkweb désigne plus généralement :
Réseau accessible uniquement via des outils spécifiques, comme le navigateur Tor.
Après, Tor ou Freenet ne sont pas vraiment des réseaux séparés, puisqu’ils utilisent l’infrastructure d’internet. On parle de réseaux « overlays », qui se superposent sur des réseaux existants.
Internet n’est qu’une sorte de reflet des activités humaines : les truands se cachent, sauf parfois pour escroquer les gens ou faire leur business. Et les gens normaux sont parfois tentés d’être discrets pour de bonnes raisons. Le darkweb sera d’ailleurs peut-être la dernière solution pour tenter de garder un soupçon de vie privée.
The Dark Web Boundaries Are Not Always Clear, and Many Sites Fall in a Gray Area
Idan Aharoni on SecurityWeek.com
Sources
- http://www.zdnet.fr/blogs/50-nuances-d-internet/
- https://www.nextinpact.com/news/105256-ne-dites-plus-darknet-mais-internet-clandestin-dark-web-mais-toile-profonde.htm
Articles externes
Rootkit
Un rootkit (en français : « outil de dissimulation d’activité »1) est un type de programme (ou d’ensemble de programmes ou d’objets exécutables) dont le but est d’obtenir et de maintenir un accès frauduleux (ou non autorisé) aux ressources d’une machine, de la manière la plus furtive et indétectable possible.
Le terme peut désigner à la fois la technique de dissimulation ou son implémentation (c’est-à-dire un ensemble particulier d’objets informatiques mettant en œuvre cette technique).
Continuer la lectureServeur FTP
Pour mettre en œuvre un serveur FTP, il faut penser à quelques éléments de sécurité. Par exemple :
- Cloisonner les utilisateurs
- Interdire les shells
- Contrôler la provenance des requêtes
L’informatique, c’est physique
Je suis un des premiers à le reconnaître, mais j’avais oublié que l’informatique était un objet éminemment physique. A l’ère du tout numérique et de la dématérialisation à tout va, à une époque où on se demande où sont stockées nos données (car bien souvent on ne le sait pas), j’ai suivi une présentation très intéressante au cours du FIC 2018 faite par un géographe, chercheur à l’université (ref), qui nous a remis à l’esprit que derrière l’immatérialité apparente de l’informatique il y avait une réalité bien tangible.
Continuer la lectureEn cas d’incident
Difficile de donner des consignes générales en cas d’incident. Le CERT-FR a tenté l’exercice avec une infographie assez générique, plutôt destinée aux petites structures1.
Toutefois, dans le cas d’un ransomware, la meilleure solution est d’éteindre immédiatement la machine.
En cas de découverte d’une faille, il est normalement obligatoire de le déclarer en bonne et due forme.2.

NFC
NFC est un acronyme pour Near Field Communication, dont je laisse la description aux spécialistes (ou aux amateurs, selon les points de vue) de wikipedia. Il s’agit d’une technologie radio qui peut être utilisée pour l’échange de données informatiques sans contact, à courte distance.
Dans le milieu où j’évolue (la banque), on redoute les concurrents de type fintechs tout en cherchant à rester en tête de l’innovation. Le NFC a évidemment alimenté les discussions, pour ne pas rater le coche, mais il est souvent judicieux d’attendre un peu avant de se lancer tête baissée dans une technologie, surtout quand elle peine à décoller : les nombreuses expérimentations menées en France ne sont guère convaincantes, et même Gartner qui fait souvent montre d’optimisme, a un avis très mesuré sur cette technologie1.
Pire : fin 2015, un an après le lancement d’un service basé sur le NFC, Apple lui-même semble échouer à faire adopter cette technologie2, principalement en raison de l’usage peu naturel pour les utilisateurs d’un téléphone comme moyen de paiement. Les banques, pourtant, ont tendance à considérer les smartphones comme le Graal des futurs moyens de paiement. Graal ? Peut-être. Mais pas tout de suite. Un autre frein à l’adoption, probablement moins important mais sans doute assez présent, est le niveau de sécurité de la technologie.
NFC : est-ce sûr ou pas ?
Comme souvent, ce n’est pas la technologie en elle-même qui possède des faiblesses (bien que cela puisse arriver), c’est plutôt la manière dont on l’utilise et dont on la met en œuvre qui est perfectible. Or pour le NFC, comme pour l’internet des objets, tout le monde ne jure que par l’usage et l’adoption, sans penser sécurité, alors que pourtant ce point est crucial pour l’adoption d’un moyen de paiement. Et tôt ou tard on s’en mordra les doigts… Or même les grands opérateurs sont parfois légers sur le sujet3. Les premières attaques seraient déjà en cours (attaque réelle ou proof-of-concept sur un utilisateur ciblé ?)4.
Références
- http://www.zdnet.fr/actualites/apple-pay-aurait-deja-vecu-son-age-d-or-39824616.htm
- http://www.gartner.com/newsroom/id/2846017